DevOps

Vi för ihop dev och drift på riktigt — inte ett team som heter DevOps, utan ett arbetssätt där samma personer bygger och kör. Mätbart bättre incidenthantering, kortare lead time.

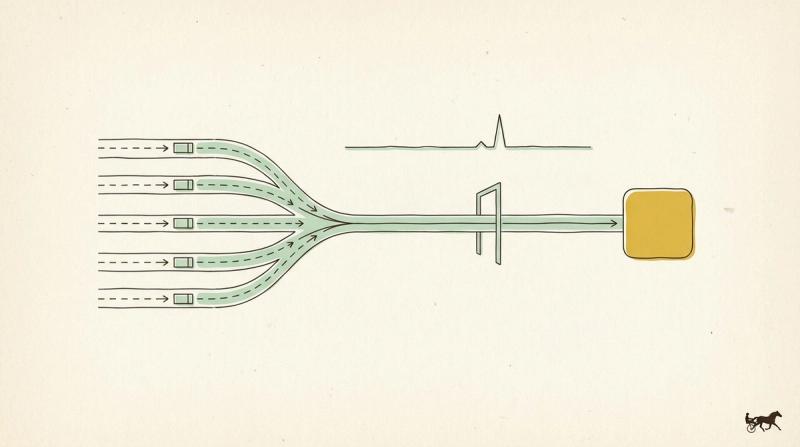
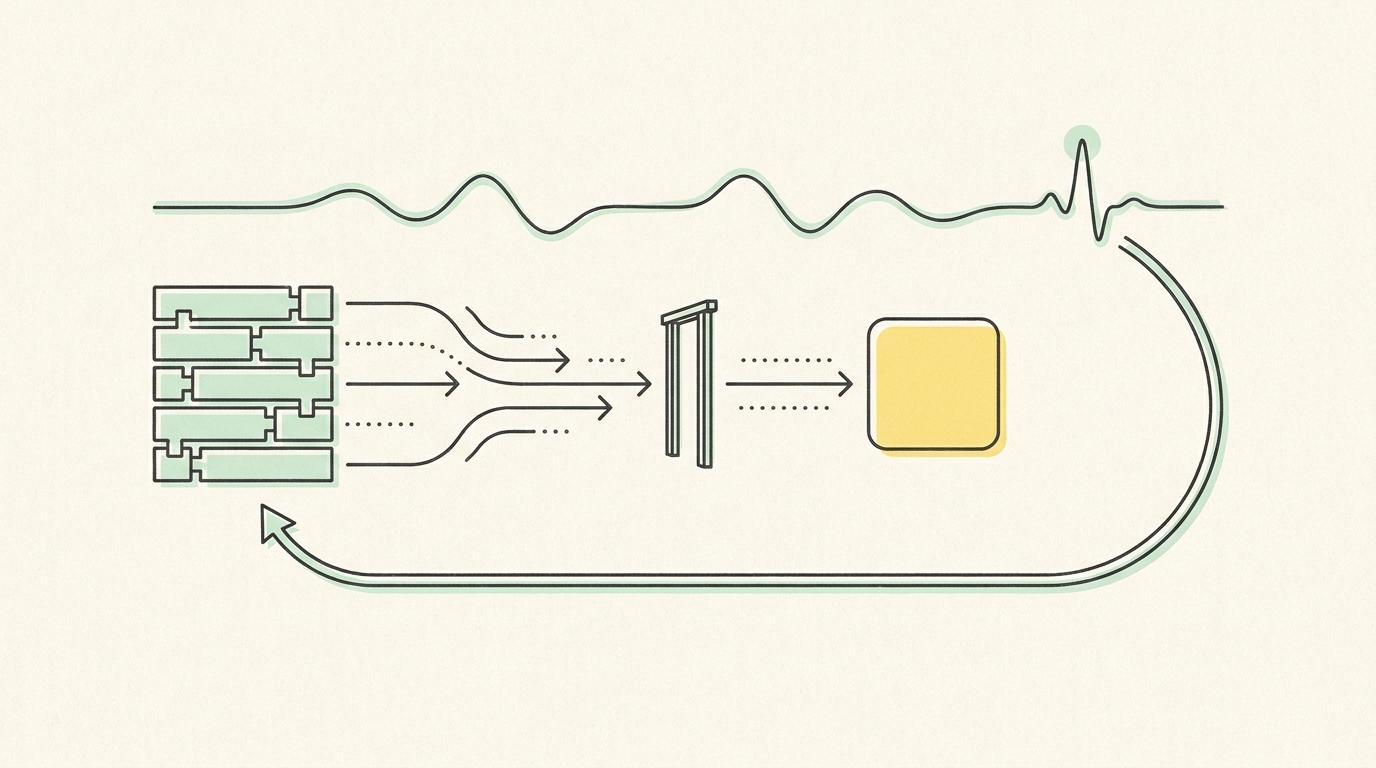
Linjeillustration: en hjärtkurva löper över ett flöde där kodblock till vänster passerar en grind och blir en gul ruta till höger, med en pil som loopar tillbaka till starten — en leveransloop med övervakning.

DevOpsDevOpsDevOps är ett arbetssätt där samma team som bygger en tjänst också ansvarar för att den fungerar i produktion — ”you build it, you run it”. Det är inte en roll eller ett verktyg, utan ett sätt att fördela ansvar mellan utveckling och drift.Läs mer i ordlistan → handlar inte om att skapa ett team som heter "DevOps". Det handlar om att förändra hur teknikorganisationer arbetar: samma personer som bygger systemet är också med och kör, övervakar och förbättrar det i produktion.

När utveckling och drift separeras uppstår ofta långa ledtiderLedtidLedtid är tiden från att en ändring är klar i kod till att den körs i produktion — ett av de fyra DORA-mätvärdena. Den mäter hur mycket väntan, handpåläggning och köer som ligger mellan utvecklaren och kunden, inte hur snabbt någon kodar.Läs mer i ordlistan →, otydligt ansvar och långsammare incidenthantering. Med ett modernt DevOps-arbetssätt blir ansvarskedjan kortare, feedbacken snabbare och kvaliteten mer mätbar.
Vad DevOps betyder i praktiken

Ett fungerande DevOps-arbetssätt bygger på att teamen tar ansvar för hela livscykeln:

  1. Bygga tjänster och funktioner.
  2. Driftsätta dem på ett säkert och repeterbart sätt.
  3. Övervaka beteende, prestanda och användarupplevelse.
  4. Hantera incidenter när något går fel.
  5. Lära sig av produktion och förbättra systemet kontinuerligt.

Det viktiga är inte verktygen i sig, utan att organisationen skapar kortare avstånd mellan kod, drift och användarupplevelse.

SRE och on-call: ansvar där systemet lever

Site Reliability EngineeringSite Reliability Engineering (SRE)SRE är ett sätt att göra drift systematisk och mätbar: tillförlitlighet uttrycks i mål (SLO:er) och felbudgetar, och teamet arbetar aktivt med larm, automatisering och förbättringar i stället för reaktiv brandsläckning.Läs mer i ordlistan →, eller SRE, är ett sätt att göra drift mer systematisk och mätbar. I stället för att en separat driftfunktion "tar över" efter utveckling, arbetar teamet aktivt med tillförlitlighet, larm, felbudgetarFelbudgetEn felbudget är den mängd fel eller nedtid ett system får ha under en period utan att bryta sitt tillförlitlighetsmål, SLO:t (service level objective). Finns budget kvar får teamet ta risk och leverera fort; är den förbrukad går stabilitet före nytt.Läs mer i ordlistan → och automatisering.

Ett bra on-call-upplägg innebär inte bara att någon har jour. Det innebär att teamet har:

  • Tydliga larm som går att agera på.
  • Runbooks för återkommande problem.
  • Mätvärden som visar faktisk användarpåverkan.
  • Mandat att förbättra systemet efter incidenter.

När de som skriver koden också får återkoppling från produktion skapas ett starkare tekniskt ägarskap.

IaC och GitOps: infrastruktur som kod

Med Infrastructure as Code blir miljöer, nätverk, policies och resurser definierade i kod. Det gör infrastrukturen mer spårbar, testbar och repeterbar.

GitOps tar detta vidare genom att använda Git som källa till sanning. Ändringar granskas, versionshanteras och rullas ut på ett kontrollerat sätt.

Fördelarna är tydliga:

  • Mindre manuellt arbete och färre konfigurationsfel.
  • Snabbare återställning vid problem.
  • Bättre spårbarhet kring vem som ändrade vad och varför.
  • Mer förutsägbara releaser över flera miljöer.

Det gör att team kan röra sig snabbare utan att tappa kontroll.

Incidenter och post-mortems: lärande utan skuld

Incidenter kommer att hända. Skillnaden mellan en mogen och omogen organisation ligger i hur man reagerar.

En stark DevOps-kultur använder incidenter som lärandetillfällen. Efter en incident bör teamet genomföra en blameless post-mortemBlameless post-mortemEn blameless post-mortem är en strukturerad genomgång efter en incident där fokus ligger på system, processer och beslut — inte på att hitta en syndabock — så att organisationen faktiskt lär sig av det som hände.Läs mer i ordlistan → där fokus ligger på system, processer och beslut — inte på att hitta en syndabock.

En bra post-mortem svarar på frågor som:

  • Vad hände?
  • Hur upptäcktes problemet?
  • Hur påverkades användarna?
  • Vad fungerade bra i responsen?
  • Vad behöver förbättras?
  • Vilka konkreta åtgärder ska göras?

Målet är att varje incident ska göra organisationen mer robust.

AIOps och autonoma agenter: nästa steg i drift

AIOps använder AI och maskininlärning för att analysera loggar, metrics, traces och incidentdata. Det kan hjälpa team att snabbare hitta avvikelser, prioritera larm och föreslå åtgärder.

Nästa steg är autonoma agenter som inte bara upptäcker problem, utan även kan hjälpa till att felsöka, skapa sammanfattningar, föreslå pull requests eller automatisera delar av incidentresponsen.

Det betyder inte att människor försvinner ur processen. Tvärtom blir mänskligt omdöme ännu viktigare. Men rätt använt kan AIOps minska brus, korta felsökningstid och frigöra tid till mer värdeskapande arbete.

Mätbara effekter av DevOps

När DevOps fungerar märks det i konkreta resultat:

  • Kortare lead time från idé till produktion.
  • Snabbare incidenthantering och lägre MTTRÅterställningstid (MTTR)MTTR (mean time to restore) är den genomsnittliga tiden det tar att få en tjänst att fungera igen efter en incident eller ett fel i produktion. Det är ett av de fyra DORA-mätvärdena och mäter stabilitet, inte fart.Läs mer i ordlistan →.
  • Färre manuella fel genom automation.
  • Högre tillgänglighet och bättre användarupplevelse.
  • Starkare ägarskap i teamen.

DevOps är alltså inte ett organisationsschema. Det är ett arbetssätt där teknik, ansvar och lärande förs samman.

Slutsats

DevOps på riktigt innebär att utveckling och drift inte behandlas som två separata världar. Det innebär att team bygger, kör och förbättrar sina system med samma ansvarskänsla genom hela livscykeln.

Med SRE, on-call, IaCInfrastructure as Code (IaC)Infrastructure as Code innebär att miljöer, nätverk, behörigheter och resurser definieras i versionshanterad kod i stället för att klickas fram manuellt — vilket gör infrastrukturen spårbar, testbar och repeterbar.Läs mer i ordlistan →, GitOpsGitOpsGitOps är ett arbetssätt där Git är källan till sanning för både infrastruktur och applikationskonfiguration: önskat tillstånd beskrivs i kod, granskas i pull requests och rullas ut automatiskt av verktyg som håller verkligheten i synk.Läs mer i ordlistan →, incidenthantering, post-mortems, AIOps och autonoma agenter kan organisationer skapa tekniska plattformar som både är snabbare, stabilare och mer lärande.

Det är där DevOps ger verklig effekt: kortare ledtider, bättre incidenthantering och system som utvecklas genom erfarenhet från verklig drift.

Uppdrag där vi gjort det här

Alla uppdrag →

Sätt att börja

Tre avgränsade sätt att börja.

Åtagandena beskriver vad vi kan. Här är tre uppdrag där det står vad ni får, vad vi behöver av er och hur det prissätts.

Kort uppdrag

Pipelinegenomgång

När byggen och releaser tar för lång tid eller går sönder för ofta.

Det här får ni

  • En genomgång av kedjan från commit till produktion: byggtider, tester, köer och manuella steg.
  • En skriftlig rapport om var tiden går och vad som bryter, i prioriterad ordning.
  • En genomgång av rapporten med ert team, med förslag på vad ni gör först.

Det här behöver vi av er

  • Läsåtkomst till repon och pipelines.
  • En person som kan kedjan och kan svara på frågor.

PrisPer timme, till det högre timpriset för korta uppdrag.

Kort uppdrag

Plattformsbedömning

När plattformen har vuxit fram bit för bit och ingen riktigt vet vad den tål.

Det här får ni

  • En genomlysning av molninfrastruktur, infrastruktur som kod, driftsättning och observability.
  • En skriftlig bedömning av vad som håller, vad som är skört och vad vi skulle göra först.
  • En genomgång av bedömningen med dem som äger plattformen.

Det här behöver vi av er

  • Läsåtkomst till molnkonton, infrastrukturkod och övervakning.
  • Tid med dem som driftar plattformen i dag.

PrisPer timme, till det högre timpriset för korta uppdrag.

Längre uppdrag

Förstärkning i ert Delivery Engineering-team

När ordinarie personal går på ledighet, eller när rekryteringen drar ut på tiden.

Det här får ni

  • En konsult som tar plats i ert team och arbetar i era verktyg, er backlog och era rutiner.
  • Pipelines, releaser och drift som fortsätter fungera medan ni är färre.
  • Överlämning när ordinarie personal är tillbaka eller tjänsten är tillsatt.

Det här behöver vi av er

  • En plats i teamet: konton, åtkomster och en kontaktperson.
  • En uppskattning av hur länge behovet varar.

PrisPer timme, till ett lägre timpris än för de korta uppdragen.

Så prissätter vi

Vi tar betalt per timme. Timpriset är högre när uppdraget är kort, som en pipelinegenomgång eller en plattformsbedömning, och lägre när vi tar en mer varaktig plats i ert team. Hör av er, så får ni timpriset för ert upplägg.

Kontakta oss →
Verktyg

Vad saknas i ert repo?

En länk, trettio sekunder, inget sparas. Arton kontroller på det som gör ett repo självförklarande — för agenter och för människor.

Öppna Repo-röntgen →
01 / 04

Upptäcka

Vi sätter oss in i affären, mappar intressenter och hittar var värdet faktiskt finns att hämta.

02 / 04

Definiera

Konkret omfattning, beslutspunkter och en plan som ni kan förankra på styrelsenivå.

03 / 04

Bygga

Korta sprintar, kontinuerlig demo, inkrementell lansering. Inga 6-månaders våtdrömmar.

04 / 04

Drifta

Vi hjälper er ta över eller stannar kvar som drift- och förvaltningspartner.

Har du ett problem värt att lösa?

Kontakta oss →